Comment scraper plusieurs URLs à la fois : sans code ou avec Python
Importez une liste d’URLs dans Octoparse sans coder ou utilisez un script Python : étapes illustrées, code prêt à copier, export Excel et bonnes pratiques.
Vous avez une liste de 50, 500 ou 50 000 adresses web et vous voulez récupérer les mêmes informations sur chaque page : prix, titre, date, auteur, coordonnées. Les ouvrir une par une n’est pas une option.
La réponse courte : pour scraper plusieurs URLs, on donne la liste d’adresses à un outil qui visite chaque page l’une après l’autre et extrait les mêmes champs partout. Sans coder, Octoparse le fait en important la liste (copier-coller, fichier Excel/CSV ou autre tâche) puis en détectant automatiquement les données. Avec Python, une boucle requests + BeautifulSoup fait le même travail.
| Votre situation | Méthode conseillée |
|---|---|
| Le site a déjà un modèle Octoparse | Modèle prêt à l’emploi |
| Site sans modèle, pas de code | Tâche personnalisée Octoparse |
| Vous codez et voulez tout contrôler | Script Python |
Ce guide détaille les trois, avec un test réel sur une liste d’articles.
Pourquoi scraper une liste d’URLs plutôt qu’un site entier ?
Le scraping d’URL (ou « URL scraping ») part d’une liste d’adresses déjà connue, au lieu de laisser un robot naviguer de lien en lien. C’est la bonne approche dans plusieurs cas fréquents.
1. Les pages d’un même site partagent la même structure. Fiches produits d’un site e-commerce, annonces immobilières, profils d’entreprises dans un annuaire : chaque page affiche les mêmes champs au même endroit. Exemple : vous suivez le prix de 300 produits précis chez un concurrent. Inutile de parcourir tout le catalogue, la liste des 300 URLs suffit.
2. Les données sont réparties sur des sites différents. Pages carrières de plusieurs entreprises, communiqués de presse de plusieurs médias, programmes de plusieurs salles de spectacle. Les pages ne se ressemblent pas, mais vous savez exactement où chercher.
3. Vous voulez les métadonnées d’une liste d’articles. Titre, nom de la publication, date de parution, auteur : c’est utile pour une revue de presse, une veille sectorielle, un audit de contenu ou une bibliographie. Exemple : 500 URLs d’articles, et un tableau avec la date et l’auteur de chacun.
4. La navigation du site gêne l’extraction. Certains sites rendent le clic de page en page peu fiable :
- défilement infini ou bouton « Charger plus » : mieux vaut d’abord collecter les URLs des fiches, puis les visiter dans une seconde tâche (voir notre guide sur la pagination) ;
- contenu chargé en AJAX : après un clic sur une fiche, le retour à la liste ne fonctionne pas toujours, et le scraper perd sa place ;
- pages lentes : ouvrir directement chaque URL évite les erreurs dues aux temps de chargement.
Un cas client illustre bien le deuxième scénario. Un éditeur indépendant d’événements basé aux États-Unis faisait saisir ses événements à la main par des stagiaires, un par un. Il collecte désormais chaque semaine les programmes d’environ 70 salles de concert et de théâtre : nom de l’événement, date, prix du billet, image, lien de réservation. Les données partent directement dans Google Sheets, et seuls les nouveaux événements sont ajoutés. Résultat : le nombre d’événements publiés est passé d’environ 450 à plus de 4 500, sans renforcer l’équipe éditoriale.
Il vous manque encore la liste d’URLs ? Commencez par l’extraire avec un extracteur de liens, puis revenez à ce guide.
Scraper plusieurs URLs sans coder avec Octoparse
Octoparse est un logiciel de web scraping no-code (Windows et Mac). Il charge chaque URL de votre liste, repère les données de la page et les range dans un tableau exportable. Deux façons de travailler :
- Option A, un modèle prêt à l’emploi, si le site cible fait partie des sites couverts ;
- Option B, une tâche personnalisée, pour tous les autres sites.
Option A : utiliser un modèle prêt à l’emploi
Octoparse propose des modèles de scraping pour des sites très demandés : Google Maps, Amazon, Leboncoin, PagesJaunes, Vinted, etc. Une partie d’entre eux accepte directement une liste d’URLs en entrée. Vous n’avez rien à configurer, seulement les adresses à fournir.
Par exemple, le modèle https://www.octoparse.fr/template/google-maps-scraper-listing-page-by-url récupère le nom, l’adresse, la note, le téléphone et les coordonnées des établissements à partir de liens de recherche Google Maps.
Comment utiliser un modèle :
- Dans Octoparse, ouvrez l’onglet des modèles et cherchez le site visé.
- Vérifiez le type d’entrée : certains modèles demandent des URLs, d’autres des mots-clés.
- Collez vos URLs, une par ligne.
- Lancez l’extraction, puis exportez les résultats.
Les modèles sont disponibles à partir du forfait Standard, et pendant l’essai gratuit de 14 jours.
Option B : créer votre propre scraper d’URLs
Si aucun modèle ne couvre votre site, ou s’il ne récupère pas exactement les champs dont vous avez besoin, créez une tâche personnalisée. L’autodétection fait l’essentiel du travail.
Pour ce test, nous avons pris les 287 articles du blog Octoparse et cherché à récupérer pour chacun le titre, l’auteur, la date de publication et le temps de lecture. C’est le scénario « métadonnées d’articles » décrit plus haut.
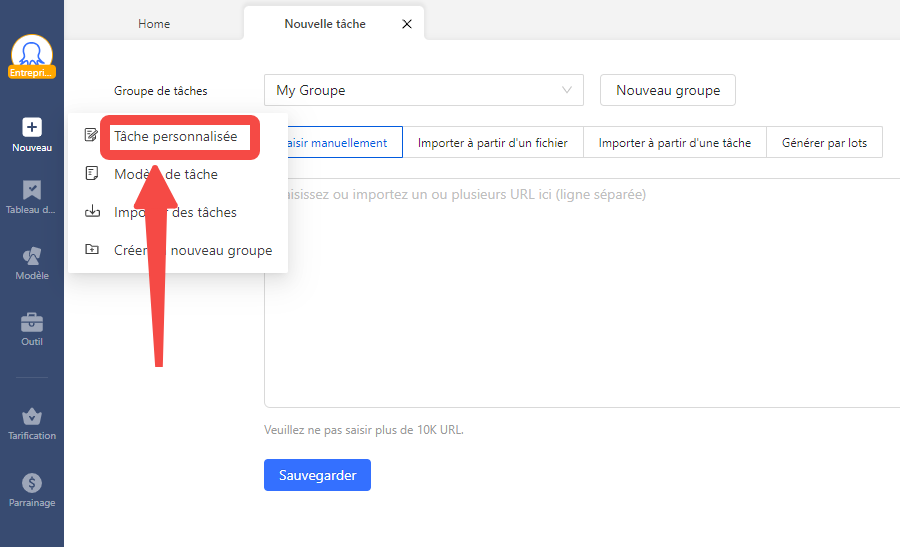
Étape 1 : créer une tâche personnalisée. Cliquez sur « Nouveau » dans le menu latéral, puis sur « Tâche personnalisée ».
Étape 2 : importer la liste d’URLs. Dans « Source d’URL », l’onglet « Saisir manuellement » accepte jusqu’à 10 000 adresses, une par ligne. Collez votre liste, puis cliquez sur « Sauvegarder ».
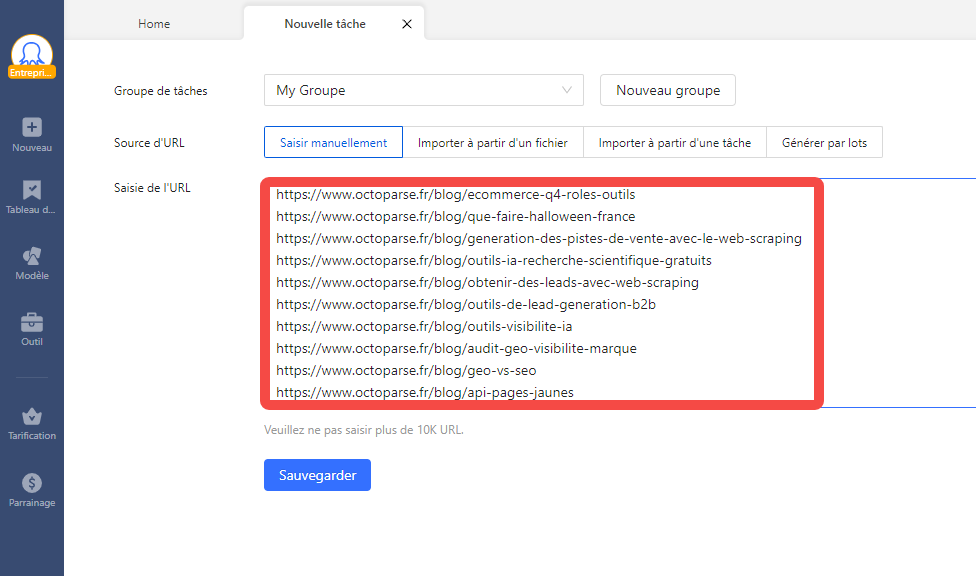
Pour une liste plus longue, ou pour éviter les copier-coller, trois autres onglets existent :
- Importer à partir d’un fichier : un fichier CSV, TXT ou Excel (pour un CSV, une seule colonne d’URLs) ;
- Importer à partir d’une tâche : les URLs collectées par une première tâche alimentent directement la seconde, sans export manuel ;
- Générer par lots : Octoparse crée les URLs à partir d’une adresse de base en faisant varier un paramètre (numéro de page, lettre, date ou liste personnalisée).
L’import par fichier ou par génération s’arrête à un million d’URLs ; l’import depuis une autre tâche peut dépasser ce plafond. Tous les détails sont dans le tutoriel Saisie d’URL par lot du centre d’aide.
Étape 3 : lancer l’autodétection. Une fois la première page chargée, cliquez sur « Autodétection des données de la page web » dans le panneau « Conseils ». Octoparse analyse la structure de la page et propose des champs.
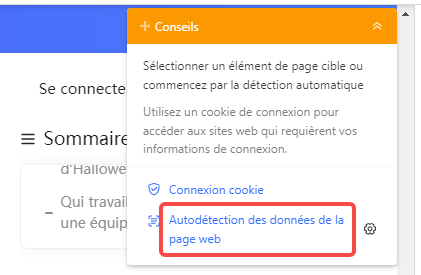
Sur nos articles, elle a trouvé le titre, la date de publication, l’auteur et le temps de lecture, mais aussi le chapeau de l’article et la biographie de l’auteur en fin de page. L’auteur apparaît donc deux fois, et certaines colonnes portent des noms génériques (« champ », « champ1 »…). Vous pouvez supprimer les colonnes inutiles et renommer les autres dans l’aperçu des données avant de lancer la tâche, ou faire ce tri plus tard dans Excel. Si un champ manque, cliquez directement sur l’élément dans la page pour l’ajouter.
Un point à vérifier : une même tâche suppose que toutes les pages ont la même structure. Si vos URLs viennent de sites très différents, créez une tâche par modèle de page. Le centre d’aide explique comment vérifier que des pages ont la même structure.
Étape 4 : lancer la tâche. Cliquez sur « Exécuter », puis choisissez l’environnement d’exécution :
- Exécuter sur votre appareil : disponible avec la version gratuite, idéal pour tester ou pour quelques centaines d’URLs ;
- Exécuter dans le Cloud : les serveurs d’Octoparse font le travail 24h/24, même ordinateur éteint, et la tâche peut tourner selon un planning (forfait Standard et plus).
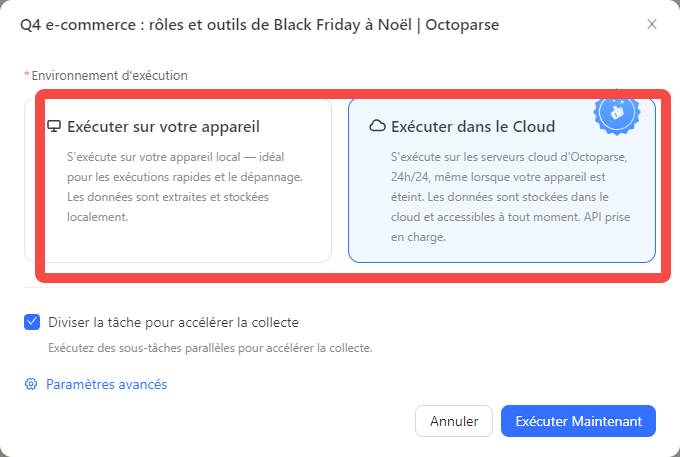
Cliquez ensuite sur « Exécuter Maintenant ». Les lignes s’affichent dans l’onglet « Données » au fur et à mesure que les pages sont visitées.
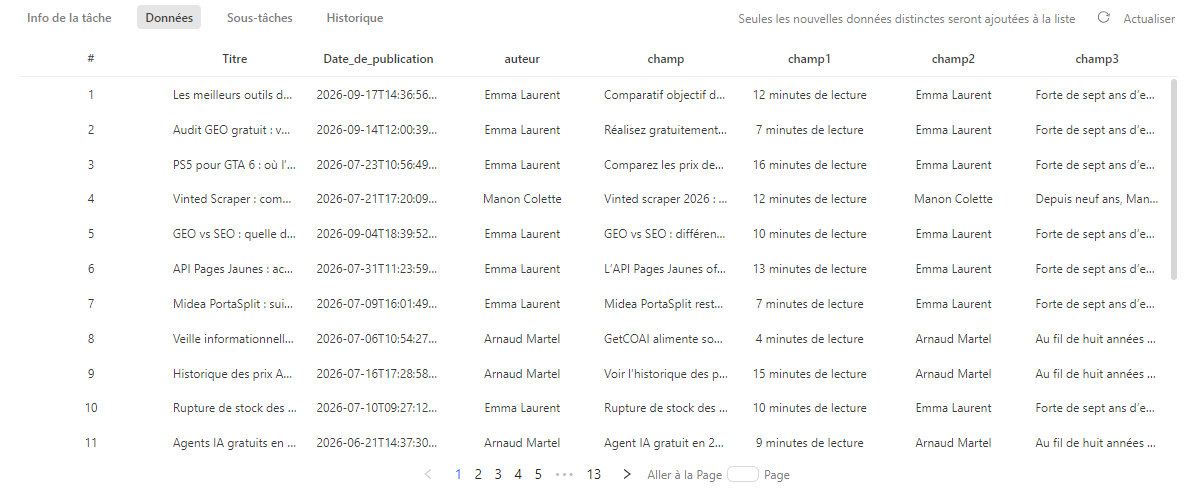
Étape 5 : exporter les données. À la fin de l’extraction, cliquez sur « Exporter » et choisissez le format :
- Excel (.xlsx) pour analyser et partager ;
- CSV pour l’importer dans un autre outil ;
- JSON pour les développeurs ;
- Google Sheets pour travailler à plusieurs (connexion via un compte de service Google, à partir du forfait Standard) ;
- base de données (MySQL, SQL Server, PostgreSQL…) : export de base dès le forfait Standard, options avancées avec le forfait Professionnel. Détails sur la page des tarifs.
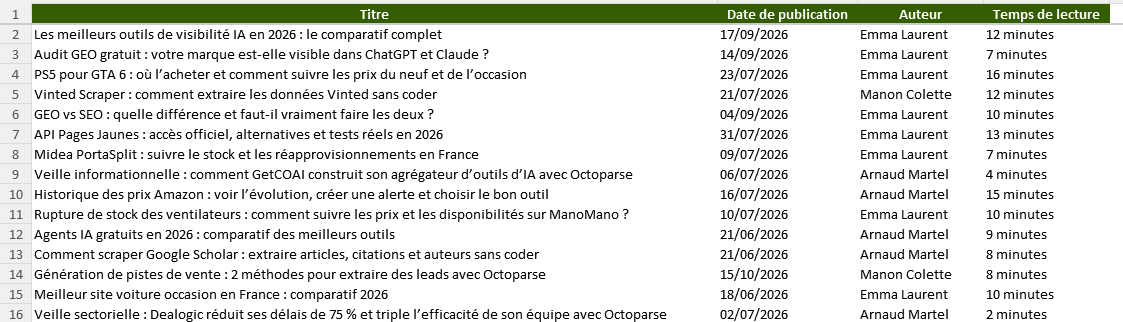
Un conseil après export : triez le tableau par colonne. Si une page ne s’est pas chargée à temps, sa ligne reste vide. Pour retrouver facilement les pages concernées, gardez une colonne avec l’URL de chaque page, puis relancez la tâche uniquement sur ces adresses.

Coller jusqu’à 10 000 URLs ou importer une liste depuis un fichier CSV, TXT ou Excel.
Laisser l’autodétection repérer les données de chaque page et construire le flux en quelques clics.
Extraire les mêmes champs sur toutes les pages : titre, prix, date, auteur, coordonnées.
Exporter les résultats vers Excel ou CSV, prêts à trier et analyser.
Scraper plusieurs URLs avec Python
Si vous savez coder, Python offre un contrôle total : logique d’extraction sur mesure, intégration dans un pipeline de données, traitement en aval. Trois bibliothèques suffisent :
- requests envoie les requêtes HTTP et récupère le HTML ;
- BeautifulSoup analyse le HTML et extrait les éléments ;
- pandas met les données en tableau et les exporte vers Excel ou CSV.
Pour un premier apprentissage plus complet, voir notre guide du web scraping avec Python, étape par étape.
Exemple 1 : récupérer le titre de chaque URL
Le script parcourt la liste, télécharge chaque page et affiche son titre. Simple, mais fragile : la première erreur réseau peut tout interrompre.
Exemple 2 : version robuste avec gestion des erreurs et export Excel
Pour un vrai projet, il faut gérer les erreurs, espacer les requêtes et enregistrer un tableau.
Chaque URL produit une ligne, même en cas d’échec : la colonne statut indique ce qui s’est passé, et vous pouvez relancer uniquement les URLs en erreur.
Exemple 3 : extraire les métadonnées d’articles
La plupart des sites d’information remplissent des balises Open Graph et meta standard. Les cibler est plus fiable que de chercher le texte dans la mise en page.
Appelez cette fonction à la place des lignes d’extraction de l’exemple 2 pour obtenir un tableau prêt pour une revue de presse ou une bibliographie.
Limite à connaître : requests ne lit que le HTML envoyé par le serveur. Si le contenu est généré en JavaScript, il faut un navigateur automatisé (Selenium, Playwright) ou un outil qui affiche la page comme Octoparse. Voir notre article sur le scraping des pages en JavaScript.
Bonnes pratiques pour scraper une liste d’URLs
Ces règles valent quelle que soit la méthode.
1. Espacez les requêtes. Une pause de 1 à 2 secondes entre deux pages évite de surcharger le serveur et réduit le risque de blocage.
2. Prévoyez les échecs. Des pages disparaissent, des serveurs ne répondent pas. En Python, une session avec relances automatiques règle la plupart des cas :
3. Identifiez votre robot. Un User-Agent explicite, avec un moyen de contact, permet au propriétaire du site de savoir qui consulte ses pages :
4. Consultez le fichier robots.txt et les conditions d’utilisation. Le robots.txt n’a pas de valeur contraignante, mais le respecter montre votre bonne foi. Lisez aussi les CGU du site.
5. Faites attention aux données personnelles. Si vos pages contiennent des noms, e-mails ou téléphones de personnes, le RGPD s’applique : collectez uniquement ce dont vous avez besoin et pour un objectif précis.
Quelle méthode choisir ?
| Situation | Méthode conseillée |
|---|---|
| Aucune compétence en code | Modèle Octoparse ou tâche personnalisée |
| Le site visé a déjà un modèle | Modèle Octoparse (forfait Standard ou essai gratuit) |
| Champs sur mesure, site sans modèle | Tâche personnalisée Octoparse (version gratuite pour démarrer) |
| Intégration à un pipeline de données existant | Script Python |
| Logique d’extraction complexe | Python + BeautifulSoup |
| Pages générées en JavaScript | Octoparse (affichage intégré) ou Python + Selenium/Playwright |
| Gros volumes ou collecte régulière | Exécution cloud Octoparse (forfait Standard et plus) ou Python distribué |
En résumé : Python si vous codez et voulez intégrer les données à vos outils ; Octoparse si vous ne codez pas ou si vous voulez un résultat rapidement.
FAQ sur le scraping de plusieurs URLs
Combien d’URLs peut-on scraper en une seule tâche ?
Avec Octoparse, la saisie manuelle accepte jusqu’à 10 000 URLs. L’import par fichier (CSV, TXT, Excel) et la génération par lots acceptent jusqu’à un million d’URLs par tâche. L’import depuis une autre tâche peut aller au-delà. En pratique, la durée dépend surtout du mode d’exécution : pour des dizaines de milliers de pages, l’exécution cloud va nettement plus vite qu’un seul ordinateur.
Toutes les pages doivent-elles avoir la même structure ?
Pour une même tâche, oui : Octoparse applique les mêmes règles d’extraction à chaque URL. Des fiches produits d’un même site fonctionnent très bien ensemble. Si vos URLs viennent de sites différents, regroupez-les par type de page et créez une tâche pour chaque groupe.
Comment obtenir la liste d’URLs à scraper ?
Trois options : copier les liens depuis un export existant (sitemap, fichier Excel), utiliser un extracteur de liens, ou créer une première tâche Octoparse qui collecte les URLs d’une page de liste. Cette tâche peut ensuite alimenter directement la tâche d’extraction grâce à l’option « Importer à partir d’une tâche ».
Existe-t-il un url scraper en ligne gratuit ?
Les outils entièrement en ligne et gratuits limitent souvent le nombre de pages ou les champs récupérables. La version gratuite d’Octoparse s’installe sur votre ordinateur mais permet déjà de scraper une liste d’URLs avec une tâche personnalisée et d’exporter vers Excel. L’exécution dans le cloud, sans garder l’ordinateur allumé, fait partie des forfaits payants.
Peut-on relancer le scraping de la même liste chaque jour ?
Oui. Avec Octoparse, une tâche cloud peut être programmée à l’heure, au jour ou à la semaine, à partir du forfait Standard. C’est utile pour suivre des prix ou des stocks sur une liste de fiches produits. En Python, on obtient le même résultat avec une tâche planifiée (cron sous Linux/Mac, Planificateur de tâches sous Windows).
Conclusion
Scraper plusieurs URLs revient toujours au même principe : une liste d’adresses, les mêmes champs extraits sur chaque page, un tableau en sortie. Si votre site a un modèle Octoparse, c’est la voie la plus rapide. Sinon, une tâche personnalisée se configure en quelques minutes sans écrire de code. Et si vous êtes à l’aise avec Python, les scripts ci-dessus sont une base solide, à condition de respecter les bonnes pratiques.

Commencer votre découverte de Octoparse dès maintenant
Lecture conseillée
Manon Colette
Découvrez 5 méthodes pour télécharger toutes les images d'un site web : extension Chrome, script Python (BeautifulSoup), bulk image downloader et Octoparse. Sans code ou avec — à vous de choisir.2026-04-29T11:29:26+00:00 · 10 minutes de lecture
Arnaud Martel
TripAdvisor Content API, modèles sans code ou script Python : trois méthodes pour extraire avis et données TripAdvisor, comparées sur leurs limites réelles, leur coût et leur cas d'usage en France.2026-03-31T18:12:11+00:00 · 12 minutes de lecture Cet article cible les trois façons d'extraire des données financières sans Python : utiliser un modèle de web scraping, construire un web scraper par lui-même, externaliser l'extraction de données à un tiers. Parmi les trois méthodes, créer un web scraper avec Octoparse semble le plus économique et efficace.2022-12-07T00:00:00+00:00 · 8 minutes de lecture
 Comment gérer la pagination avec un scraper web? Il existe un grand nombre de méthodes telles que la pagination numérotée, le défilement infini, etc. Nous allons maintenant illustrer les approches permettant de traiter les différents types de pagination avec Octoparse.2021-10-11T00:00:00+00:00 · 5 minutes de lecture
